
שאלון הבחירות הישראלי: איך מתרגמים עמדות פוליטיות למודל מתמטי?
|
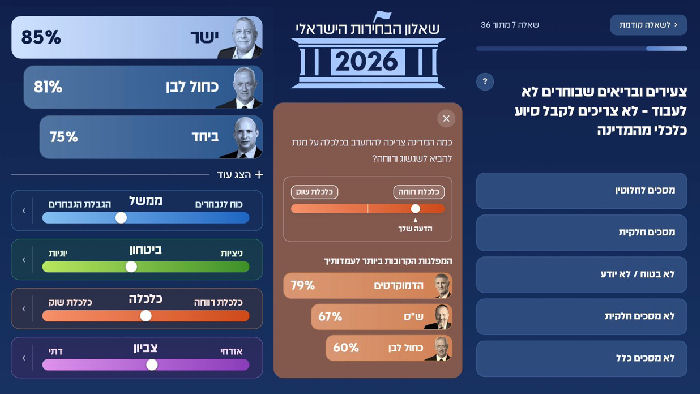
לקראת הבחירות 2026 פיתחנו את “שאלון הבחירות הישראלי”, כלי שמאפשר למשתמש לענות על שאלות בנושאי מדיניות ולקבל דירוג של המפלגות הקרובות ביותר לעמדותיו. במקום להסתפק בשאלה כללית כמו “האם אתה ימני או שמאלני?”, השאלון בוחן עמדות קונקרטיות בנושאים שבהם המפלגות נדרשות לקבל החלטות.
שאלון הבחירות הישראלי: איך מתרגמים עמדות פוליטיות למודל
מתמטי?
גלעד שקד
לקראת הבחירות פיתחנו את
“שאלון הבחירות הישראלי”, כלי שמאפשר למשתמש לענות על שאלות בנושאי מדיניות ולקבל
דירוג של המפלגות הקרובות ביותר לעמדותיו. במקום להסתפק בשאלה כללית כמו “האם אתה
ימני או שמאלני?”, השאלון בוחן עמדות קונקרטיות בנושאים שבהם המפלגות נדרשות לקבל
החלטות.
הרעיון לפרויקט נולד מתוך
תחושה שהשיח הפוליטי בישראל מתמקד לעיתים קרובות בזהות, במחנות וביחס למועמדים,
ופחות בהשוואה מסודרת בין עמדות מדיניות. גם כאשר קיימים שאלוני התאמה, לא תמיד
ברור כיצד חושבו התוצאות, כיצד מופו המפלגות ומה המשמעות המתמטית של אחוז ההתאמה
שמוצג למשתמש.
בנינו גרסה ראשונה של
השאלון בשנת 2025, ובתוך כשבועיים מילאו אותו יותר מ־50 אלף איש. לקראת בחירות
2026 החלטנו לבנות את הפרויקט מחדש ולהעמיק הן את תהליך מיפוי המפלגות והן את
המודל המתמטי שמחשב את התוצאות.
השאלון כולל 36 שאלות
בארבעה תחומי ליבה: ממשל, ביטחון, כלכלה וצביון. לכל שאלה ממופים גם המשתמש וגם
המפלגות על אותו סולם עמדות. תשובות המשתמש מתקבלות ישירות במהלך מילוי השאלון,
ואילו עמדות המפלגות נקבעות מראש על בסיס מצעים, פרסומים רשמיים, התבטאויות,
הצבעות ומקורות פומביים נוספים.
אחרי שיש בידינו את
תשובות המשתמש ואת מיפוי המפלגות, נותרת הבעיה המרכזית: כיצד מודדים את מידת הקרבה
ביניהם?
לשם כך אנחנו משתמשים
במרחק וקטורי. אפשר לייצג את אוסף התשובות של המשתמש כווקטור, כלומר רשימה סדורה
של מספרים, ולעשות את אותו הדבר עבור כל מפלגה. כל שאלה היא ממד נפרד בווקטור. ככל
שתשובות המשתמש והמפלגה דומות יותר לאורך כלל הממדים, המרחק ביניהם קטן יותר.
את המרחק מחשבים באמצעות
מרחק אוקלידי, שהוא ההכללה הרב־ממדית של מדידת המרחק הישיר בין שתי נקודות. בכל
שאלה בודקים את הפער בין תשובת המשתמש לתשובת המפלגה, מעלים אותו בריבוע ומצרפים
אותו לפערים בשאר השאלות.
השימוש בהפרשים ריבועיים
משיג שתי מטרות. ראשית, הוא מבטיח שכל מחלוקת תגדיל את המרחק, בלי שפערים בכיוונים
מנוגדים יבטלו זה את זה. שנית, הוא מעניק משקל רב יותר למחלוקות גדולות מאשר
למחלוקות קטנות. פער בין הסכמה מלאה לאי־הסכמה מלאה משמעותי יותר מפער בין הסכמה
מלאה להסכמה חלקית, והמודל צריך לשקף זאת.
התשובות מקודדות על סולם
שבין -2 ל־2. הסכמה מלאה
מקבלת 2, הסכמה חלקית 1, תשובה ניטרלית או חוסר ודאות מקבלים 0, אי־הסכמה חלקית -1 ואי־הסכמה מלאה -2.
את המרחק בין המשתמש לכל
מפלגה מחשבים בנפרד בכל אחד מארבעת הצירים. ככל שהמרחק בציר מסוים קטן יותר, ציון
ההתאמה של המפלגה באותו ציר גבוה יותר. ההפרדה בין הצירים מאפשרת למשתמש לראות לא
רק איזו מפלגה קרובה אליו באופן כללי, אלא גם היכן בדיוק נמצאות ההסכמות
והמחלוקות.
הציון הכללי נקבע בהתאם
לסדר העדיפויות שהמשתמש בוחר בתחילת השאלון. הציר שדורג ראשון מקבל משקל של 65%,
השני 20%, השלישי 10% והרביעי 5%. כך שני אנשים שנתנו תשובות דומות יכולים לקבל
דירוג מעט שונה אם אחד מהם מייחס חשיבות רבה יותר לביטחון והשני לכלכלה.
אלא שלמודל כזה יש בעיה.
מפלגות שנמצאות קרוב למרכז עשויות ליהנות מיתרון מתמטי מסוים על פני מפלגות
שמציגות עמדות חדות יותר. המרכזיות הזאת יכולה לנבוע משני מצבים שונים לחלוטין:
מתינות אמיתית, שבה למפלגה יש עמדה ברורה אך מתונה, או עמימות, שבה לא נמצאה
למפלגה עמדה ברורה כלל.
אם שני המצבים מקודדים
באותה צורה, השאלון מעניק למעשה יתרון למפלגות שנמנעות מהבעת עמדה. מפלגה שלא
הציגה עמדה במספר גדול של נושאים עלולה להיראות קרובה יחסית למשתמשים רבים, לא
משום שהיא באמת מסכימה איתם, אלא משום שאין די מידע שמאפשר לזהות את המחלוקת.
כדי להתמודד עם הבעיה
הוספנו למודל “קנס עמימות”. הרעיון הוא להתייחס לחוסר עמדה לא כאל עמדה מתונה, אלא
כאל סיכון עבור המשתמש. כאשר למפלגה יש עמדה ברורה, המשתמש יודע לפחות מהי
מדיניותה המוצהרת. כאשר אין לה עמדה, היא עשויה בעתיד לתמוך במהלך מסוים או לפעול
נגדו, והמשתמש אינו יודע איזה מן התרחישים יתממש.
הסיכון הזה מתורגם
לתוספת מרחק באמצעות ממוצע הפרשים ריבועיים. גודל הקנס תלוי בעמדת המשתמש. כאשר
עמדתו מתונה, אי־הוודאות כרוכה בתוספת מרחק קטנה יחסית. כאשר עמדתו נחרצת, הסיכון
שהמפלגה תפעל בכיוון המנוגד לה גדול יותר, ולכן גם תוספת המרחק גדולה יותר.
הקנס תלוי גם במספר
השאלות שבהן למפלגה אין עמדה. חוסר עמדה נקודתי גורר קנס קטן, משום שכמעט לכל
מפלגה יש נושאים שעליהם לא התבטאה. ככל שמספר השאלות ללא עמדה גדל, המכפיל של הקנס
עולה באמצעות פונקציה לא־לינארית. כך המודל מבחין בין חוסר מידע מקרי לבין מצב שבו
למפלגה אין למעשה עמדה מגובשת בתחום שלם. מעבר לסף מסוים של שאלות ללא עמדה,
המפלגה כלל אינה מומלצת למשתמש באותו ציר.
בסופו של דבר, המטרה אינה
לומר למשתמש למי להצביע. הצבעה מושפעת גם מאמון, הנהגה, סדרי עדיפויות ושיקולים
שאי אפשר לצמצם לנוסחה. מטרת השאלון צנועה יותר: לספק נקודת פתיחה שקופה ומבוססת
להשוואה בין עמדות המשתמש לבין עמדות המפלגות, ולהפוך בחירה פוליטית מופשטת לדיון
קונקרטי יותר במדיניות.